第一次打开 ncu 报告,很容易有一种感觉:每个数字都认识,合在一起却不知道该改哪一行。
SM 吞吐不高,是线程太少,还是在等内存?Occupancy 提高了,为什么还是慢?shared memory 明明更快,为什么把数据搬进去反而没赚到?
我更愿意把这些章节当成一组接力的问题。上一章缩小范围,下一章补充证据,最后才轮到改代码。报告负责解释发生了什么,独立 benchmark 负责判断改动有没有用。
图 1:分析顺序示意。遇到明确证据时可以跳到对应章节,不必每次把所有指标读一遍。
本文以 Nsight Compute 2025.1.1 的常见章节为基础,结合 NVIDIA 2026.3.1 在线文档解释新增命名与架构差异。界面图片来自 NVIDIA 官方文档,图里的示例数值属于官方示例;文中的矩阵加法对照另有测量条件。不同版本、GPU 与采集配置,章节内容和可用指标会变化。
目录
- 先决定:这个 kernel 值得优化吗
- 先读懂报告里的“百分比”
- Launch Statistics:先确认你交给 GPU 的任务
- GPU Speed Of Light Throughput:先选调查方向
- Compute Workload Analysis:具体是哪条通路在干活
- Memory Workload Analysis:数据到底走了哪条路
- Occupancy:有多少 warp 驻留,不是有多少线程正在计算
- Scheduler Statistics:驻留的 warp 真能发射吗
- Warp State Statistics:等待发生了什么,不是时间损失账单
- Instruction Statistics:GPU 实际执行了多少额外工作
- Source Counters:把证据落到源码与 SASS
- Roofline:把“做多少计算、搬多少数据”放在一起
- 章节与版本:full 不等于全部可查询指标
- Replay、warm / cold:别把采集条件当成自然运行
- 回到 benchmark:让结论落在时间上
- 随手查:一个现象,先接哪条证据
先决定:这个 kernel 值得优化吗
nsys 是 Nsight Systems 的命令行工具,适合看整个程序的时间线:CPU 在做什么,GPU 有没有空档,拷贝与计算能否重叠,哪几个 kernel 占住关键路径。ncu 是 Nsight Compute 的命令行工具,更适合放大一个 kernel,看内部资源和指令执行。
先用 nsys 找热点,再用 ncu 深挖,通常更省力。一个 kernel 单次很短,但每步调用几千次,也可能值得优化;另一个 kernel 虽然很长,却与别的工作重叠,缩短它不一定缩短总时间。统计累计耗时后,还要回到时间线确认它是否拖住了最终结果。Nsight Systems 官方文档 介绍了这种系统级分析。
下面是命令模板,需把程序和参数换成自己的;采集在支持 CUDA 的 NVIDIA GPU 机器上执行。查看报告的电脑可以是另一台机器,GUI 能打开远程采集的 .ncu-rep,并不意味着本机能运行 CUDA。
# 先获得系统时间线;NVTX 可用于标记目标阶段。
nsys profile --trace=cuda,nvtx -o timeline ./app

# 再了解当前安装实际提供什么。
ncu --version
ncu --list-sets
ncu --list-sections
ncu --query-metrics --query-metrics-mode all

# 示例:只采一个名称匹配的目标 kernel。
ncu --kernel-name 'regex:matrixAddGlobal' --launch-count 1 \
    --section LaunchStats --section SpeedOfLight \
    --section MemoryWorkloadAnalysis -o initial ./app
有预热和多次相同调用时,还要用 NVTX、--launch-skip,或程序里的 cudaProfilerStart/Stop 配合 --profile-from-start off,选中所需的那次调用。否则,你以为采的是稳定阶段,实际采到了第一次冷启动。命令选项以所装版本的 CLI 文档 为准。
这篇文章的贯穿例子
考虑 FP32 矩阵加法:每个线程计算一个元素,C[i] = A[i] + B[i]。对照版本先把 A、B 放进 shared memory,block 内同步,再读取 shared 完成加法。为保留真实中转,对照实现让 warp 搬入相邻行,由其他 warp 消费数据。
两版数学工作相同,每个输入元素只用一次。shared 版没有创造数据复用,只增加 shared 的写、读和一次同步。因此,“shared 的访问延迟低”还不足以支持它更快。
这组已有测量采用 NVIDIA L20(Ada,计算能力 8.9)、CUDA 12.8、ncu 2025.1.1,编译使用 -O3 -lineinfo -arch=native。输入为 ,block 为 ,共 256 个线程,grid 为 ,共 1,024 个 block。A、B、C 各 1 MiB,合计逻辑读写量 3 MiB;shared 版额外申请 2,048 字节动态 shared memory / block。
独立 CUDA Event 计时复用相同缓冲区,先预热 10 次,每轮连续运行 100 次,交替顺序测 6 轮,取每次 kernel 平均耗时的轮间中位数。计时不含 H2D/D2H,两版都通过全部 262,144 个元素的正确性检查。它衡量的是小矩阵的稳定重复执行,不能外推到首次执行或更大工作集。
先读懂报告里的“百分比”
后面的章节里,最容易混淆的是三类问题:有多少 warp 驻留、调度器有没有发射指令、某个硬件资源用了多少峰值能力。 它们对应不同分母,不能互相替代。
图 2:阅读指标需要的资源模型。箭头表示主要数据路径,未画出所有硬件部件,也不代表每一代 GPU 的物理布局。
SM 与执行 pipe 是什么
SM(Streaming Multiprocessor)可以理解为 GPU 里的一个工作车间。block 被安排到 SM 上,线程按 warp 组织;CUDA 中一个 warp 有 32 个线程。SM 内的调度器从驻留 warp 中挑选可执行的指令,送到相应执行通路。
pipe 是处理一类指令的通路。物理 pipe 对应实际硬件,逻辑 pipe 则是 profiler 为分析组织的抽象,可能汇总多个物理通路。 一个指令可能动态选择通路,也可能同时使用多个资源。因此,图里的 pipe 不是一组可以直接相加的独立“核心”。
| 通路 | 直觉与常见工作 | 读报告时的边界 |
|---|---|---|
| FMA | 常见 FP32 加法、乘法、乘加 | 名称不表示只做乘加;某些架构还处理整数乘法、IMAD 等 |
| FP64 | 双精度运算 | 能力随芯片差异很大,不能拿 FP32 峰值作为分母 |
| ALU | 位运算、逻辑和多种整数操作 | 不能简单理解为“全部整数指令”;具体归属依架构 |
| LSU | 向内存路径发起 load、store、atomic 等 | 还可能处理 shuffle、特殊寄存器读取等;LSU 忙不等于 DRAM 忙 |
| Tensor | 矩阵乘加等 Tensor 指令 | 精度、指令族与架构决定吞吐;新架构的 tc 与 tensor 命名也要区分 |
例如 GA10x 的 FMA 是汇总逻辑通路,包含 Heavy / Lite 子通路;部分整数和浮点工作会竞争共享的物理资源。换代后,名字、分组和计数方式可能改变。先查询目标 GPU,再读该架构说明,不能把一台机器的 pipe 百分比原样套到另一台。官方 Pipelines 定义 给出了具体归属。
active 与 elapsed:忙起来有多满,整个窗口又有多满
先看一个纯示意:某个资源在 100 个 elapsed cycles 中,只有 40 个周期符合它的 active 定义。在这 40 个周期内,它完成了相当于可持续峰值 80% 的工作,那么按整个窗口算就是 32%。
active 看资源处于活跃状态的周期,elapsed 看测量窗口内经过的周期。各硬件单元有自己的 active 定义;它不是“全 GPU 活跃”,也不等于一次指令的延迟。公式还涉及硬件实例汇总和指标本身的归一化,示意中的乘法不能替代真实 metric 定义。
以 sm__throughput.avg.pct_of_peak_sustained_elapsed 为例:
sm是硬件单元;smsp则是 SM 子分区,范围更细。avg是跨硬件实例的平均;sum、min、max分别是总和、最小和最大。平均值可能藏住负载不均。pct_of_peak_sustained_elapsed表示按 elapsed 周期,对可持续峰值归一化的百分比。
.pct 也可能表示命中率等普通比值,分母是查询次数,而非周期。指标里的 pred_on、读写类型、内存空间等限定词,还会进一步缩小统计范围。
综合 throughput 通常取其组成计数器归一化百分比的最大值,不是把所有 pipe 求平均,也不是统一换算为 FLOP/s。 其中一个资源很忙,就能把综合值抬高;浮点运算可能并不多。具体查看 breakdown 和 metric tooltip。Metrics Structure 解释了这些后缀与组合规则。
Launch Statistics:先确认你交给 GPU 的任务
这一章像任务单:grid、block、线程数、寄存器、shared memory,以及估计的 Waves Per SM。它先回答“工作量和资源需求是否合理”,不是在评价线程执行效率。
| 指标 | 分母或范围 | 怎么看 |
|---|---|---|
| Grid / Block Size | 本次 launch 的 block 数、每 block 线程数 | 看覆盖范围、warp 是否完整、是否有大量边界线程 |
| Registers Per Thread | 每线程的寄存器资源需求 | 看它是否限制同时驻留的 block;与编译和采集方式一起解释 |
| Shared Memory Per Block | 每 block 的 shared 资源 | 区分静态、动态及工具展示的 driver / 总分配量;别只看源码声明 |
| Waves Per SM | grid block 数相对全 GPU 可同时驻留 block 容量的估计 | 很小可能填不满 GPU;非整数可能出现不满的尾部 |
Waves Per SM 的直觉,是“这一车工作相当于几车间容量”。它不是测出来的同步执行轮数:block 结束后会继续调度,实际运行并不是所有 SM 整齐地一起开始下一波。
矩阵加法虽然有 262,144 个元素,报告里的 Waves Per SM 也只有约 1.86。对这样的短 kernel,启动、填充和收尾的影响不小,不能因为理论 Occupancy 高就认定整段时间都满载。
tail effect 是最后只剩少量工作时,多数 SM 或 warp 已经空出来,而总完成时间还由剩下的工作决定。block 内也可能有类似现象:一些 warp 早早退出,另一些仍在执行,资源不能马上全部释放。
常见误判是“block 越大越好”。大 block 可能减少调度灵活性,还会增加寄存器或 shared 资源的整块占用。合理的尝试包括调整 block 形状、增加独立工作、减少不均匀任务,或把许多小任务融合;每种改动都要保留数据映射和正确性约束。Launch Metrics 可核对资源口径。
GPU Speed Of Light Throughput:先选调查方向
Speed Of Light,简称 SOL,是“离资源峰值还有多远”的概览。常见字段包括 Compute (SM) Throughput、Memory Throughput、L1/TEX、L2、DRAM Throughput,以及 Duration、频率和周期数。
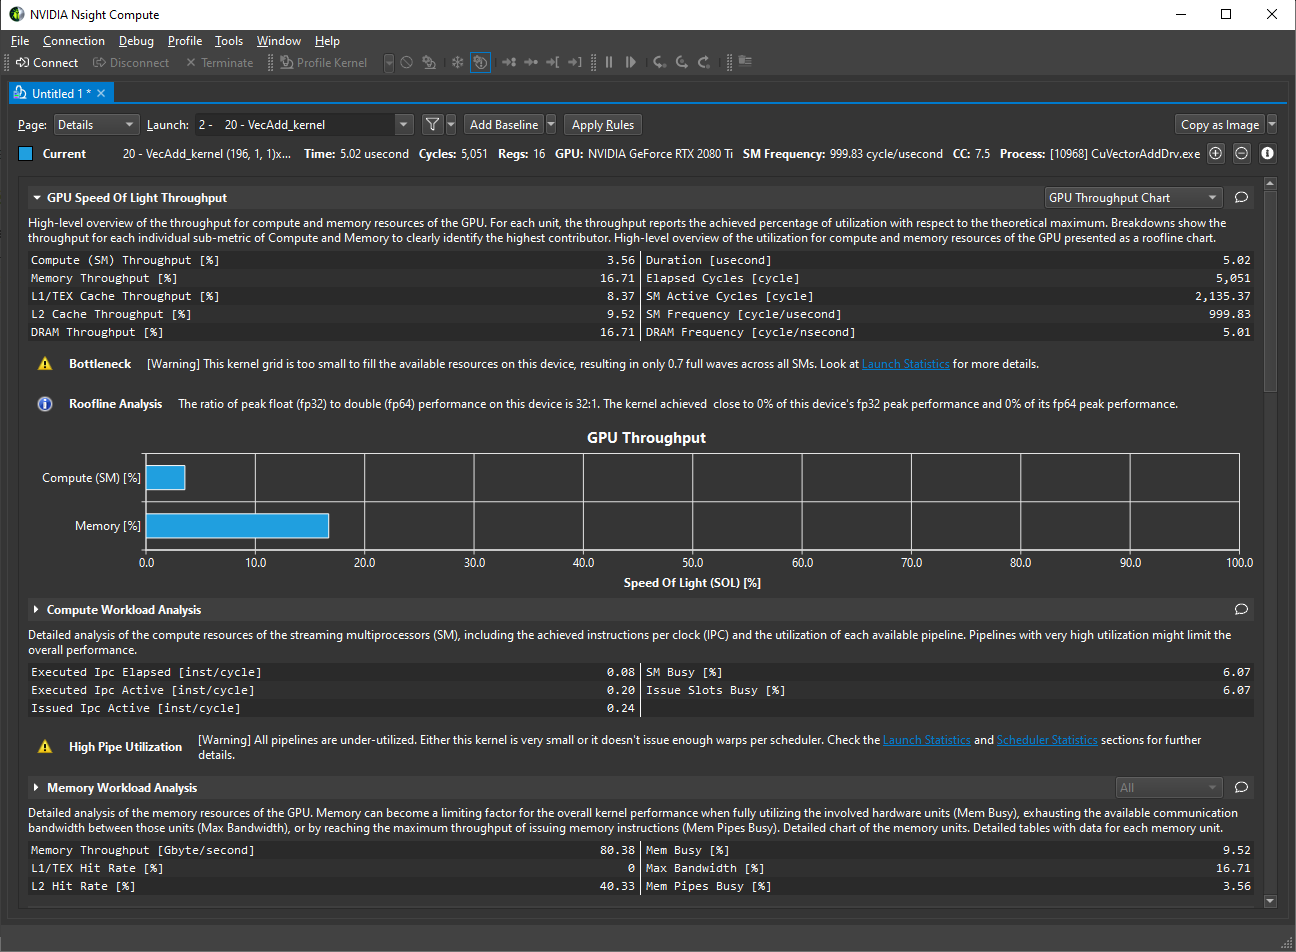
图 3:NVIDIA 官方 Navigate the Report 示例截图,© NVIDIA Corporation & Affiliates。用来辨认报告布局;示例数值不属于本文矩阵加法实验。
这一章里的资源百分比以对应峰值为参照;Duration 则是这次被采集 kernel 的测量时间,不能把两者混成一个成绩。
| 初步现象 | 下一步要确认什么 | 可尝试的方向 |
|---|---|---|
| 某计算资源接近峰值 | 是哪条 pipe、哪种指令?有没有多余工作? | 减少计算、改变算法或精度,使用合适的指令路径 |
| 某内存资源接近峰值 | 是 DRAM、L2、L1TEX,还是访存指令通路? | 减少搬运、增加复用、改善合并访问,减少请求 |
| 计算和内存都不高 | 工作量、发射、依赖、同步、分布是否有问题? | 转向 Launch、Scheduler、Warp 与 Source |
没有一个通用的“低于 60% 就坏了”阈值。极短任务、串行依赖或少量 block,本来就不容易达到长期稳定峰值;高吞吐也可能来自不必要的指令。
本例 warm profile 中,直接版 SM Throughput 为 14.12%,shared 版为 29.70%,但 Duration 从 2.624 μs 变成 2.720 μs。数字更高,时间反而更长。这提示我们:更多 shared 操作可以让资源更忙,却不增加有用的矩阵加法结果。需要继续看内存和指令,不能就此宣布“利用率翻倍,优化成功”。
Compute Workload Analysis:具体是哪条通路在干活
把 SM 想成一间有不同工位的车间,SOL 只说“有个工位很忙”,Compute Workload 才告诉你忙的是谁。常见内容包括 IPC(每周期指令数)、发射活动,以及各执行 pipe 的利用情况。
IPC 的分子是对应范围的指令计数,分母是对应单元的 active 或 elapsed cycles;先读完整指标名。warp 级指令数不是线程级指令数,指令数也不是 FLOP 数。FP32 FADD 每个参与线程通常是 1 FLOP,FFMA 通常按 2 FLOP 计算;Tensor 指令的工作量还取决于矩阵形状和数据类型。
看这一章时,我会先把实际指令类型与 kernel 的目的对上。矩阵加法需要加载、地址计算、加法和写回,FMA 百分比不高很正常。纯 FP32 kernel 的 FP64 或 Tensor 利用率为零,也不是缺陷。
如果某条 pipe 接近上限,而其他 pipe 很闲,要检查工作是否只能依赖这条路径。可减少重复地址运算、冗余类型转换,或在保持语义的条件下组织更多独立运算。若有长串 x = f(x),增加 warp 或独立累加链可能隐藏依赖;但循环展开会增加代码和寄存器需求,可能带来新的代价。
反过来,所有 pipe 都不高时,继续盯着浮点峰值通常没有帮助。要查有没有足够的可发射 warp,以及访存和同步是否让它们一起等待。
常见误判是把 FMA、ALU、Tensor 等百分比相加算“总利用率”。逻辑与物理通路可能重叠,计数器还可能统计不同单位。调优应根据瓶颈通路与依赖证据,而不是让每根柱子都变高。
Memory Workload Analysis:数据到底走了哪条路
“内存慢”太宽泛。这里至少有三种情况:搬的字节太多,访问过于零散,或者单次访问的依赖延迟无法被其他工作掩盖。对应的证据并不相同。
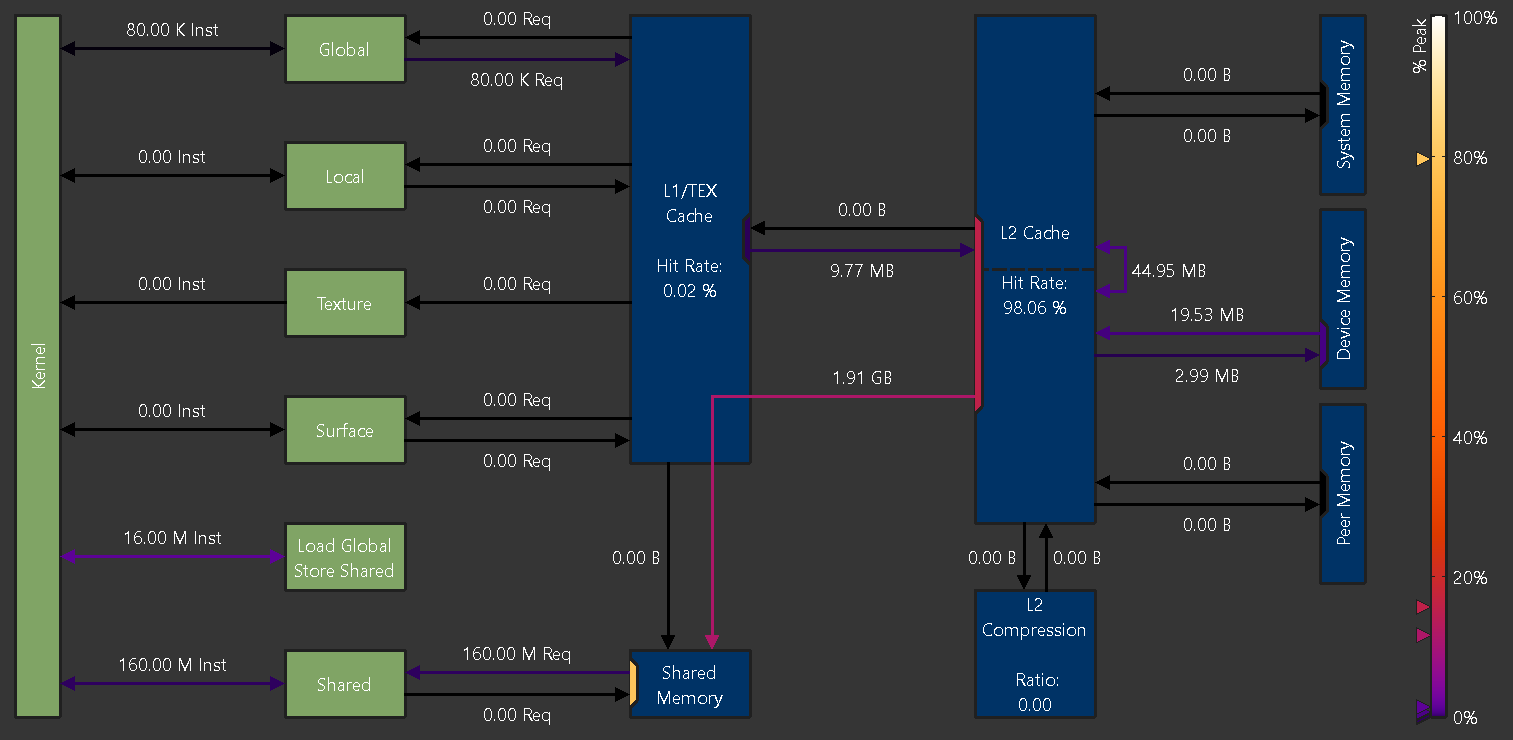
图 4:NVIDIA Memory Chart 的 A100 示例,© NVIDIA Corporation & Affiliates。路径与指标范围可帮助阅读报告;A100 的容量和结构不能直接套到其他 GPU。
先沿图看请求,再看传输量,最后看峰值归一化的忙碌程度:
- Mem Busy 更接近内存单元处理活动有多忙。
- Max Bandwidth 关注相关单元之间的带宽使用。
- Mem Pipes Busy 关注 SM 发出访存指令的通路是否忙。
名字下的实际 metric 随架构变化。Memory Throughput 高,不保证 DRAM 带宽高;数据可能命中 L2,或者时间花在 shared / L1TEX 的服务能力上。
request、sector、wavefront:三个不同问题
request 可以理解为一条访存指令进入相关路径后形成的请求;它不是“一个线程读一次”那么简单。以常见 L1TEX 模型为例,一个 warp 的一条 global 访问会按参与线程的地址形成请求。
sector 是缓存访问的粒度,现代 NVIDIA GPU 常见计数中,一个 sector 为 32 字节。wavefront 则是相关处理阶段一次能服务的工作包;一个 request 至少形成一个 wavefront,也可能拆成多个,分周期处理。
sectors/request 描述地址分布,wavefronts/request 描述服务需要多少轮。 两个请求即使都访问 4 个 sector,也可能因为路径约束、cache line 分布等原因,需要不同的 wavefront 数。不能拿 sector 数直接当延迟,也不能把所有额外 wavefront 都称为 bank conflict。官方 Memory / Requests 模型 解释了它们的关系。
图 5:sector 与 bank 是两种分析粒度。连续、对齐的 32 个 FP32 元素共 128 B,理想情况下覆盖 4 个 32 B sector;图中 shared 示例采用 32 banks 的 32-bit word 映射。
对连续 FP32 标量读取,完整 warp 若按 32 B 对齐,通常只需 4 个 sector。若每个 lane 都落到不同 sector,就会为相同的有效数据引入更多事务。可尝试让 warp 沿连续维度访问、调整布局或对齐。这个“4”不是所有访问的标准答案:向量宽度、参与 lane 数、读写类型都要一起看。
缓存命中率的分母,究竟是哪一批请求
L2 hit rate 通常按对应的 sector 查询统计命中比例,不是“程序需要的所有字节中有多少在缓存里”。整体、read、write、atomic 等分类的分母不同。只读命中率与整体命中率必须分开;L1 的命中率也不能代表 L2。
更高的命中率未必更快。一个版本可能增加了许多能命中的重复读取,把比例抬高了,却没有减少总工作。要同时看绝对 sector 数、字节量、指令数和耗时。
本例工作集总量 3 MiB,小于这块 L20 的 96 MiB L2,反复用相同缓冲区时,输入留在 L2 是合理的。warm profile 中 DRAM read 接近零,并不表示 A、B 没被读取,而是这一层之外的路径服务了访问。DRAM write 在短采集窗口内为零,也不意味着 C 从未写入:写入可能先到缓存,后续回写不在该窗口内,具体还要看缓存策略与对应计数范围。
shared memory 不是 global 数据的自动缓存。 数据需要代码显式搬入。若每个元素只用一次,直接版已有缓存服务,shared 版仍要支付额外写、读和同步。
shared bank 与 cache sector 别混在一起
shared memory 的 bank 可以理解为并行服务窗口。现代常见模型是 32 个 bank,相邻 32-bit word 分配到相邻 bank;同一服务轮次里,不同地址落到同一 bank 会导致串行化。同一地址的读取可以广播,不能按线程数算成多路冲突。
看 shared 表时,先核对访问宽度及理想 wavefront 数,再看 bank conflicts 或 excessive wavefronts。128-bit 向量访问本来就可能需要多个服务轮次;轮次多不自动等于冲突。
对转置式访问,可尝试 padding、布局调整或适合目标架构的 swizzle;先推导地址到 bank 的映射,再验证计数变化。bank conflicts 为零只说明这一类浪费没有出现,不能证明 shared 中转本身有收益。 广播、向量访问和具体架构规则可参照 CUDA Best Practices 的 Shared Memory。
Occupancy:有多少 warp 驻留,不是有多少线程正在计算
Occupancy 的直觉是“车间里挂了多少组待办工作”。warp 驻留后,即使等数据、等同步,仍然可能计入 active warps;这里的 active 不等于这一周期发射了指令。
理论 Occupancy 由 block 大小、寄存器、shared memory、每 SM 的 block / warp 上限等推算。Achieved Occupancy 则反映执行过程中实际驻留 warp 的平均情况;常见指标是 sm__warps_active.avg.pct_of_peak_sustained_active,分母与 SM 活跃周期及架构的最大驻留 warp 数有关。它不是“32 个 lane 中有几个在干活”,也不是对每一个 idle SM 的全时段利用率。
理论很高、实际较低时,先找 grid 太小、尾部、block 工作不均,或 block 内部分 warp 提前结束。若 launch 容量本来就受寄存器或 shared 限制,再考虑减小资源需求或调整 block。
本例四份报告的理论 Occupancy 都是 100%,warm 两版的实际值却约为 60.18% 和 66.19%。共享版更高仍然不能证明更快:驻留得更久、等待得更多,也可能把平均驻留数量抬上去。
提高 Occupancy 的意义,是在一个 warp 等待时提供其他候选工作。若现有 warp 已足以保持发射,再多未必有收益。强行限制寄存器,可能引发 spill,把线程私有值放到 local memory;local 是地址空间,通常依靠设备内存和缓存服务,名字不表示片上高速存储。
所以这一章的调优标准是“能否改善延迟隐藏,同时不增加更大的代价”。计算器给的是资源容量上限,benchmark 才给时间结果。官方 Occupancy 章节 与 Occupancy Calculator 可配合使用。
Scheduler Statistics:驻留的 warp 真能发射吗
这一章把上一章的“有工作”继续拆开:
- Active Warps:调度器管理的驻留 warp。
- Eligible Warps:下一条指令的输入依赖已满足、执行资源可用等,具备发射条件。
- Issued Warp:本周期实际被选中发射的 warp。
常见的 Warps Per Scheduler 是按调度器和周期平均的数量;Issue Active 是有发射活动的周期比例。它的分母要看 metric 是 active 还是 elapsed,范围是 SM 还是 SMSP。一个被选中 warp 在特定架构与条件下能发射一条或多条指令,不能把“每周期一个 issued warp”直接理解为整个 SM 只做一条指令。
如果 Active 很多,Eligible 却经常接近零,说明候选工作一起等住了。再去看依赖、访存或同步。若 Eligible 充足,Issue 也高,而某条 pipe 已接近峰值,那么资源吞吐可能才是约束,继续堆 warp 未必有效。
常见误判是只提高 Active Warps,就以为发射一定改善。调度器不能发射尚未等到输入的指令。可尝试组织独立计算、提前发起加载、减少不必要同步,或改善线程块中的工作均衡;这些尝试应由下一章的 stall 和源码证据支持。
Scheduler 是进入 Warp State 的门槛。只有发射出现明显空档时,优先消除 stall 才更可能换来时间收益。
Warp State Statistics:等待发生了什么,不是时间损失账单
一张 stall 图很容易让人产生“最大那根就是元凶”的冲动。可 warp 在等待时,其他 warp 可能正在工作。同一时刻有很多 warp,不能把它们的等待周期直接加成 kernel 耗时。
常见 Warp State 图给出的是某状态下的平均 warp cycles / issued instruction。Source 页面则可能展示采样次数或相对百分比,它们的分母又不同。读数前先确认图表单位;一个“30%”不能未经核对就说成“kernel 有 30% 时间被浪费”。
| 状态 | 在等什么 | 怎么追到可修改的原因 |
|---|---|---|
| Long Scoreboard | L1TEX 相关操作产生的数据依赖,常见于 global / local / texture | 找等待结果的消费者,再追前面的 load;查访问分布、复用、并行度与 spill |
| Short Scoreboard | MIO 路径的依赖,常见于 shared,也可能来自特殊数学或动态分支 | 核对 shared 操作与 bank 统计,不能仅凭名称认定有冲突 |
| Barrier | 等同 block 的其他 warp 到达同步点 | 查同步前的负载不均、分支与搬运;不能直接删掉必要的同步 |
| LG / MIO Throttle | 相应指令队列或路径压力 | 减少冗余请求,合适时合并较窄访问,改善布局并穿插独立计算 |
| Math Pipe Throttle | 需要的数学通路暂时不能接受更多工作 | 对照 Compute 的 pipe 利用率,减少该通路工作或改变指令组织 |
| Wait | 固定延迟执行依赖 | 检查串行链,考虑独立累加与适度展开 |
| Not Selected | 已有发射资格,但本周期选了别的 warp | 通常说明还有候选工作,不是真正的 stall,不以降到零为目标 |
Long Scoreboard 不等于“DRAM miss”:命中 L2 仍然会有取数延迟和依赖。Barrier 大也不保证同步指令本身很贵,可能是较快 warp 在等落后的伙伴。
更合理的判断链是:Issue 偏低 → Eligible 不足 → 某类等待突出 → Source/SASS 找到依赖或访问 → 提出改动。 假如发射已经很充分,图里仍有很多 Not Selected 或等待,也不必把它们逐项“修到零”。Warp Stall Reasons 给出了状态含义与采样归因边界。
Instruction Statistics:GPU 实际执行了多少额外工作
这一章看机器指令的构成。SASS 是 GPU 最终执行的机器指令表示;CUDA 源码和 PTX 都不能直接代替实际 SASS 的动态执行统计。
常见的 Instructions Executed、每 opcode 计数、访存和控制类占比,能解释某个版本为什么资源更忙。分母要区分:warp 级计数每个 warp 执行该指令增加一次,线程级计数则考虑参与线程;动态计数也不是“反汇编文本里有多少行”。
比例变了还不够,要看绝对数量。某类指令比例降低,可能只是另一类变多;一个宽 load 指令也可能涵盖更多字节和内部工作,不能用指令数量单独估计访存成本。
在矩阵加法对照里,应检查 shared 版是否确实保留了 shared store / load 和同步,以及是否增加地址计算。如果只是自己写 shared、自己读 shared,编译器可能把中转消掉,这样测到的就不是设想中的对照。
谓词与“32 个线程是否都有效”
谓词可以理解为执行指令时的开关,例如 SASS 的 @P0:只有条件为真的线程实际完成对应操作。编译器可能把很短的 if 转成谓词执行,源码有分支,机器码未必有对应的跳转。
Average Active Threads Per Warp 常见口径是线程级执行数除以 warp 级指令数,最多 32;Average Not Predicated Off Threads Per Warp 进一步只数谓词为真的线程。前者高、后者低,可能说明不少 lane 走到指令位置却被关掉。
边界线程、分支分歧、谓词执行都可能影响这两个数,不能混成“Occupancy 低”。Tensor 等特殊指令的发起线程与实际计算范围也可能不同,不能用普通逐线程标量运算的直觉解读所有架构。
可尝试减少冗余指令、改善边界处理、调整线程到数据的映射,或用合适的向量操作;每一次都要确认编译后确实走了预期路径。很短的边界判断通常有其必要性,不能为了平均活跃线程数而删掉安全检查。
Source Counters:把证据落到源码与 SASS
前面的章节告诉你“哪里可能有问题”,这一章才帮助你找到相关代码位置。它包括分支、线程参与情况、按位置归因的访存统计,以及 sampled warp stall reasons;Source 页面是查看这些数据与 CUDA / SASS 映射的地方,并不与 Source Counters 章节完全等同。
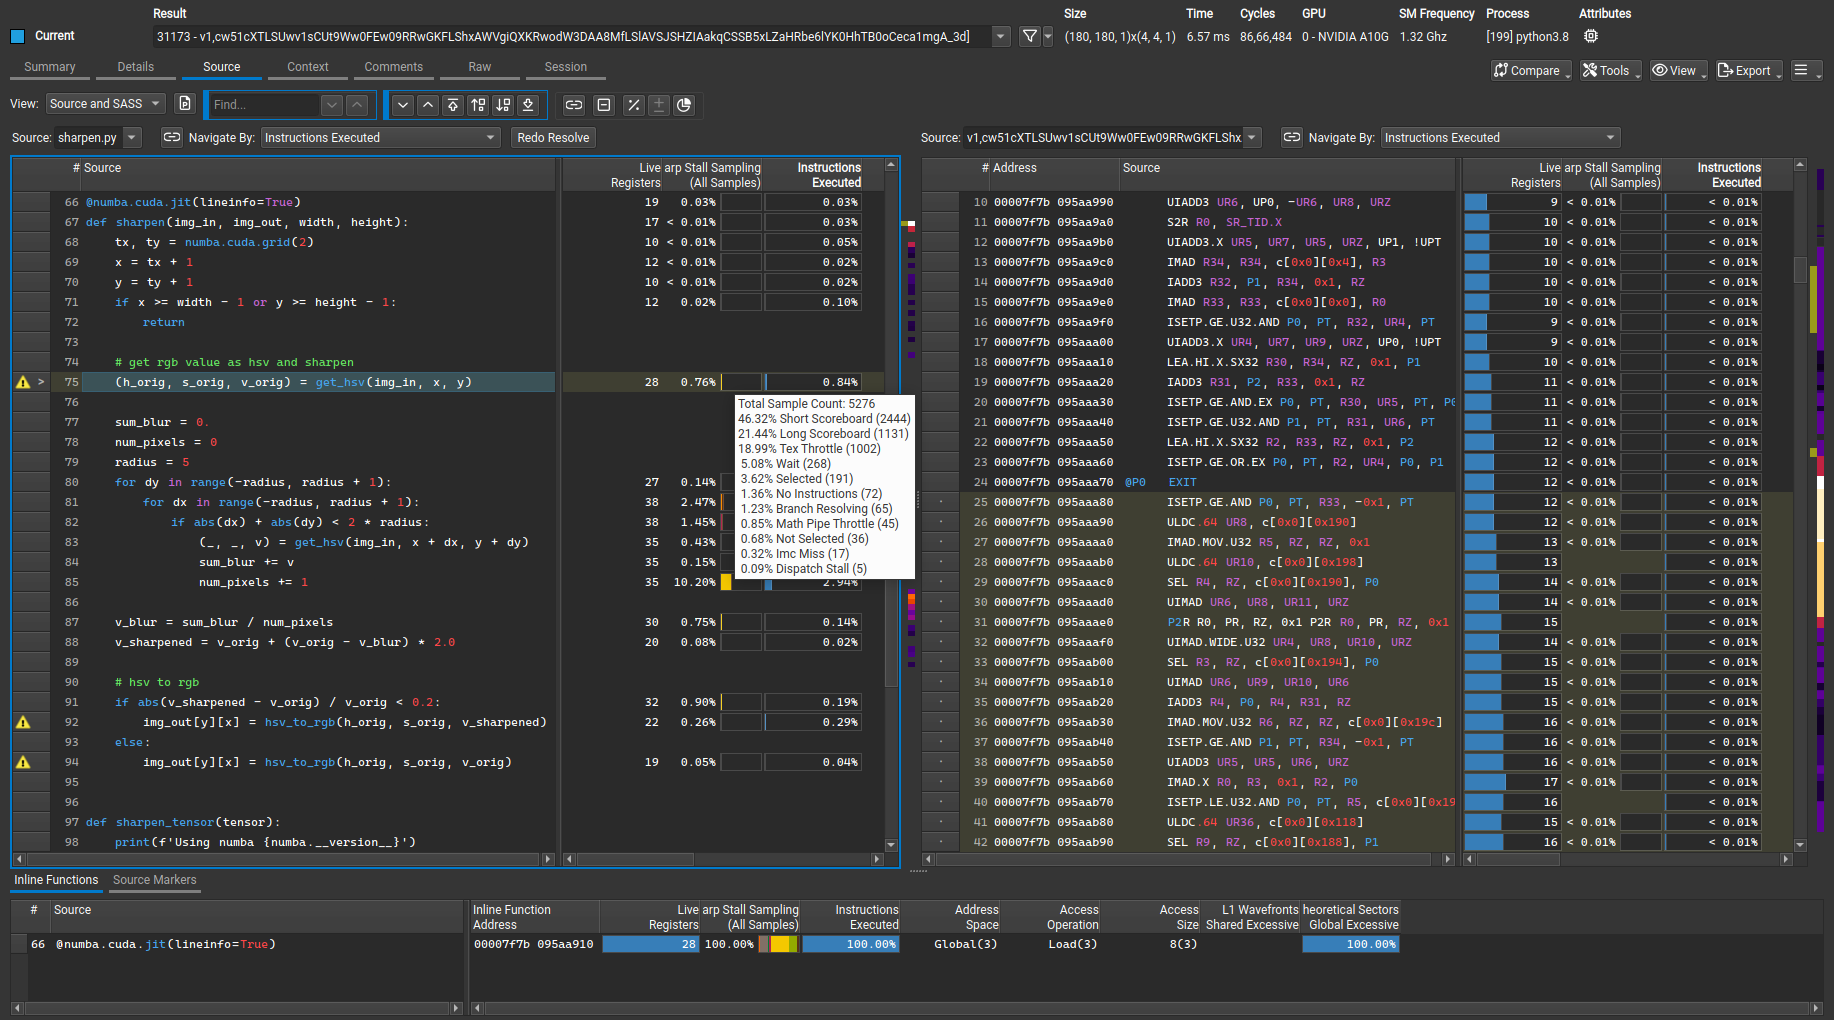
图 6:NVIDIA Source Page 示例截图,© NVIDIA Corporation & Affiliates。这里的高级源码是 Numba 的 Python CUDA kernel;同一页面也可查看 CUDA-C 等支持的源码。按行显示的值需要结合当前绝对 / 相对模式阅读。
建议保留优化编译,增加 -lineinfo;不要用 -G 的调试构建代替生产性能测量。采集时可用 --import-source yes 把可找到的源码嵌入报告,便于在另一台电脑查看;只有行号信息但缺少源码文件时,需要为 GUI 配置源码查找路径。
源码与 SASS 不是一一对应。内联、展开、公共表达式消除和指令重排,可能让一行源码对应多条 SASS,或多行映射到同一位置。热力图的颜色只能帮助找位置,不能把那一行当成完整的因果解释。
stall 样本经常记在等结果的消费者指令上。例如加法在等前面的 load,热度可能落在加法处;优化对象可能仍是 load 的地址模式、并发或缓存路径。
不同列的分母也要分别看:branch efficiency 描述所统计分支目标的统一程度,不能代表全部指令中有效 lane 的比例;stall 百分比可能相对采样总数,不能换成源码逐行耗时。短 kernel 样本少,排名容易波动,缺失值也可能意味着没采、没映射或不支持,不能填成零。
SourceCounters 会使用采样,也可能包含 SASS patching 得到的软件计数。patching 会插入采集工作,某些详细指令统计来自这种机制,不宜把有插桩的一次执行当作正常耗时。若“shared 版增加等待”的猜测需要进一步证实,应补采相同条件下的 Scheduler、Warp 与 Instruction 章节;现有四份报告没有这些完整章节,不能据此编造某个 stall 占比。Source Metrics 和 Sampling 可核对具体方式。
Roofline:把“做多少计算、搬多少数据”放在一起
Roofline 是一张性能上限地图。横轴是算术强度,即每搬运一字节做多少浮点工作;纵轴是每秒完成的浮点运算。斜线来自带宽上限,水平线来自计算峰值,通常都使用对数坐标。
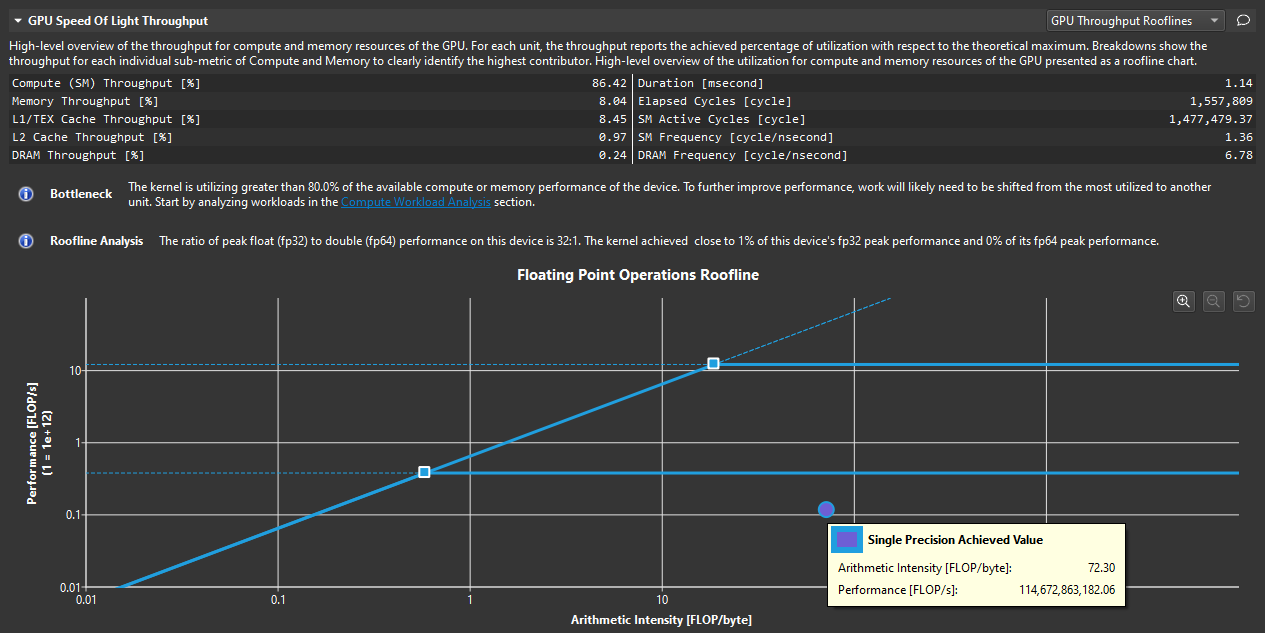
图 7:NVIDIA Roofline Charts 示例截图,© NVIDIA Corporation & Affiliates。FP32、FP64 等计算口径与相应 roof 必须配对,不能只看点的颜色或位置。
简化的上限关系是:
这里的 byte 属于选定的内存层级。DRAM、L2、L1 的实际流量不同,hierarchical roofline 可以分别展示。FLOP 也要与 FP32、FP64、FP16 或 Tensor 的真实执行路径一致,FMA 常按 2 FLOP 计;不能把不同精度混起来,对着宣传页上最大的峰值归一化。
矩阵加法每个元素做 1 次加法,逻辑上读两个 FP32、写一个 FP32,算术强度为:
这是算法的逻辑计数,不是 ncu 测出的 DRAM intensity。缓存命中和写回时机会改变实际 DRAM 字节数;warm 场景里读流量接近零时,DRAM 口径的算术强度会很敏感。shared 版还增加片上流量,而这个简化公式没计入。
低算术强度提示“搬运值得调查”,却不证明这一小矩阵已经把 DRAM 带宽吃满。若测量点离屋顶很远,可能是延迟、工作量、发射或尾部限制。位于斜线一侧也不代表通过任何缓存优化都能达到该线。
有复用的矩阵乘可以通过 tile 减少同一数据的重复搬运;一次性矩阵加法则可考虑消除冗余读写、融合相邻操作,或调整批量以减少小任务开销。融合也会增加资源需求,收益仍要验证。整数或位运算为主的 kernel,用浮点 roofline 解释时尤其要谨慎。Roofline 官方说明 给出了图的范围。
章节与版本:full 不等于全部可查询指标
section 是把相关指标组织成一章,set 是若干 section 的集合。--set full 采的是这个版本定义的 full 集合,不等于把目标 GPU 所有可查询指标、所有可选图表和所有实例数据都采一遍。 未采集的章节也不会因为在另一台电脑打开报告而自动补齐。
| 界面章节 | 常见 section identifier |
|---|---|
| Launch Statistics | LaunchStats |
| GPU Speed Of Light Throughput | SpeedOfLight |
| Compute Workload Analysis | ComputeWorkloadAnalysis |
| Memory Workload Analysis | MemoryWorkloadAnalysis |
| Occupancy | Occupancy |
| Scheduler Statistics | SchedulerStats |
| Warp State Statistics | WarpStateStats |
| Instruction Statistics | InstructionStats |
| Source Counters | SourceCounters |
| Roofline 概览 | SpeedOfLight_RooflineChart |
2026.3.1 在线文档还列出独立的 MemoryWorkloadAnalysis_Chart、MemoryWorkloadAnalysis_Tables,以及 Single / Double / Half / Tensor 的 hierarchical roofline sections。新版本也有 PM Sampling、Workload Distribution 和新架构专用分析。它们的名称、集合归属与适用 GPU 以本地 --list-sections、--list-sets 为准;旧教程中的“这里有一张图”,不保证当前采集配置一定显示。
需要补查调度与指令时,可以针对选中的 kernel 添加:
ncu --kernel-name 'regex:matrixAddGlobal' --launch-count 1 \
    --section LaunchStats --section SpeedOfLight \
    --section ComputeWorkloadAnalysis --section MemoryWorkloadAnalysis \
    --section Occupancy --section SchedulerStats --section WarpStateStats \
    --section InstructionStats --section SourceCounters \
    --import-source yes -o focused ./app
这是章节组合模板,不保证一次 pass 完成,也没有替你规定预热和缓存策略。先少量采集缩小范围,出现具体疑问再加章节,通常比一开始对所有调用采 full 更容易解释。
除了版本,还要确认 GPU 架构与采集限制。某个 pipe、Tensor 指令、采样功能不支持时,不能拿别的架构的同名数字填上。指标、rule 警告和图表来自 section 定义;升级 GUI 也不能让旧报告长出未采过的证据。Sets and Sections 说明了二者的关系。
Replay、warm / cold:别把采集条件当成自然运行
硬件计数器无法同时采所有指标,ncu 可能需要多次 pass。Kernel replay 会重放目标 kernel,并管理相关内存状态;application replay 则重跑程序,让目标 kernel 之前的操作也重新发生。前者适合可重放的独立 kernel,后者有利于重建程序中的预热过程,但也要求不同运行能匹配到同一个目标,输入和执行足够一致。
默认的 cache control、clock control 和并发处理会影响观察。ncu 默认会为重放控制缓存,通常也会尝试控制时钟;支持情况和 replay 模式有边界。采集时的执行隔离、序列化、软件计数与采样也可能改变程序节奏,因此 ncu Duration、nsys 时间线和 Event benchmark 不一定相同。
本例分两种条件:
- cold:
--cache-control all --replay-mode kernel,每个采集 pass 前由 profiler 清缓存。 - warm:
--cache-control none --replay-mode application,每次程序重跑先预热,再采同一个目标调用。
两者均设置 --clock-control none。warm 表示按该程序重建的缓存条件,并不保证每个 pass 的状态完全一致;cold 也不是清缓存动作本身计入 kernel 时间的“系统冷启动”。只关 cache control 而不重建前置操作,不能保证重放可复现真实 warm 状态。Replay、Cache Control 和 Clock Control 解释了采集干预。
| 采集条件 | 直接 global:ncu Duration | shared 中转:ncu Duration | L2 整体命中率:global / shared |
|---|---|---|---|
| cold profile | 4.960 μs | 4.768 μs | 35.31% / 35.37% |
| warm profile | 2.624 μs | 2.720 μs | 100.49%(异常) / 99.99% |
cold profile 中 shared 时间略小,warm 中则略大。这些是具体采集条件下的单次报告结果,不能跳过重复 benchmark,把其中一个选出来当作稳定提速。
100.49% 命中率应当怎么解释
物理意义上的命中次数不会超过对应查询次数;这里不能解释为“缓存效率超过 100%”。 warm global 的 read hit rate 是 100%,整体 L2 hit rate 却是 100.49%,二者范围不同,异常也不能被只读指标掩盖。
ncu 会保留超出预期范围的原始结果,不主动截断。若 hits 与 queries 来自不同 pass,小 kernel 的工作分布、缓存状态和其他 GPU 活动稍有变化,就可能让派生比值不一致。本例只有约 2–5 μs,远短于容易进入稳定状态的长任务,应该排查多 pass 波动;现有报告不足以唯一确认异常根因。
可先减少采集指标,尽量让比值的组成计数在同一 pass 收集;重复同条件测量,检查后台活动和 replay 的确定性。必要时用更长、结构相同的工作调查机制,但改变规模后的结果要单独记录,不能替换原任务的性能结论。保留 100.49% 并标异常,比改成 100% 更方便追查。Range and Precision 对越界派生值有明确说明。
命中率的逻辑上限,与 pct_of_peak_sustained 的峰值归一化是两类问题:后者在某些边界条件下可能超过可持续峰值参考,不能把这种说明拿来解释超 100% 的 hit rate。
回到 benchmark:让结论落在时间上
到这里,证据支持的解释是:小工作集在重复执行时可以由缓存服务;shared 版没有减少 global 输入读取,却增加片上中转与同步。这是可以继续用 Instruction 和 Source 检查的机制,不是仅凭章节警告推出来的结论。
脱离 profiler 后,本例的 Event 计时结果是:
| 版本 | 6 轮的中位数(每次 kernel) | 各轮平均值的范围 |
|---|---|---|
| 直接 global | 2.509 μs | 2.488–2.673 μs |
| shared 中转 | 2.591 μs | 2.580–2.642 μs |
shared 的中位数约慢 3.3%,两版轮间范围又有重叠。这足以否定“这里加 shared 就天然更快”的预期,但不足以把一个小差值推广成所有 GPU、所有 shape 的稳定退化。继续增加重复轮次,并换成真实业务的缓存与数据生命周期,才能评价交付收益。
按逻辑 3 MiB 除以时间,直接版可得到约 1,254 GB/s 的 effective bandwidth。这是算法有效字节率,不是 DRAM 实测带宽。 缓存复用下它可以高于显存接口带宽,不能据此推断 DRAM 达到了这个数值。
Event 计时应让起止事件包住同一 stream 中的目标工作,并等待结束事件完成;对于极短 kernel,批量计时还会受到连续提交的 GPU 间隙影响。要把预热、数据传输、分配、同步和计时范围说清楚,保留交替顺序与多个样本,避免拿最小值当普遍收益。独立计时的方法可参照 CUDA Timing。
GUI 里的 baseline / current 对照很方便:先把基线加入 Compare,再看耗时、流量、pipe 和指令差异。但它只是整理证据的工具,不能替代一致的输入、缓存、编译和计时条件。绿色的变化不一定有益,减少指令也不保证最终更快。
一次可落地的改动应该留下四件事:改了什么、为什么应该有效、哪些指标验证了机制、独立时间与正确性结果是什么。最后回到 nsys 或业务 benchmark,确认关键路径和总延迟也改善。若只有吞吐柱子变高,用户并没有因此更早拿到结果。
随手查:一个现象,先接哪条证据
| 你看到的现象 | 下一步 |
|---|---|
| SOL 两边都低 | Launch 看规模与尾部;Scheduler 看 Issue 与 Eligible |
| 理论 Occupancy 高,实际低 | 看 grid、工作不均、warp 提前退出;不要先压寄存器 |
| Memory Throughput 高,DRAM 低 | 看 L1TEX / L2 / shared 和访存通路的 breakdown |
| Long Scoreboard 高 | 先确认 Issue 不足,再追消费者依赖的 load;不等同于 DRAM miss |
| shared wavefront 多 | 对照访问宽度、理想 wavefront 与 excessive;再判断 bank conflict |
| 命中率提高但变慢 | 看总请求和字节量,有没有新增重复工作与同步 |
| SM 吞吐提高但变慢 | 查指令和 pipe 构成,并用独立计时验收 |
| 命中率超过 100% | 保留异常,查分母、pass、缓存与并发波动 |
| full 报告里缺图或列 | 查该版本 set / section 和目标架构支持;缺失不等于零 |
读 ncu 不需要背下所有 metric。先明确正在回答哪个问题,再找范围和分母匹配的证据。一份好报告最终应该让你能说清楚:这个 kernel 花时间在哪里,哪次改动减少了什么工作,以及正常运行到底节省了多少时间。